Java集合笔记
概述:
数组与集合的区别?
| 特性 | 数组 (Array) | 集合 (Collection/List) |
|---|---|---|
| 容量大小 | 固定。一旦创建,长度不可改变。 | 动态。可以根据需要自动扩容或缩减。 |
| 存储类型 | 既可以存基本数据类型(int, double),也可以存对象。 | 通常只能存对象(基本类型会被自动装箱为包装类)。 |
| 性能 | 极高。因为内存连续,访问速度最快。 | 较高。但由于有额外的管理开销,略逊于数组。 |
| 访问方式 | 支持直接访问 | 通过迭代器访问 |
| 功能扩展 | 功能单一,仅提供 .length 和索引访问。 | 丰富。提供排序、搜索、去重、各种算法接口。 |
说说集合?
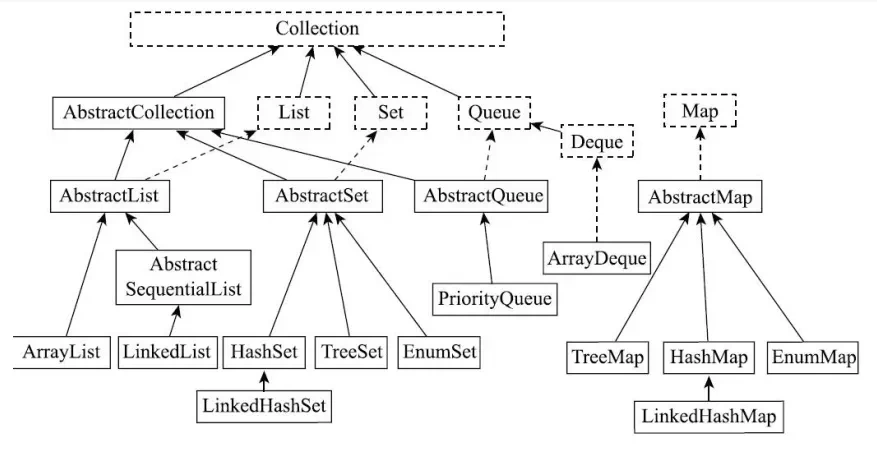
集合框架分为两个体系:实现 Collection 接口的单列体系,实现 Map 的双列体系
Collection:作为单列集合的顶层接口,定义了增删改查等基础接口,同时,它继承了 Iterable 接口,所以也能使用迭代器进行遍历
- List:有序,有索引,可重复的集合,常用:ArrayList,LinkedList
- ArrayList:容量可变,线程不安全,底层是数组,所以随机访问速度快,增删速度慢
- LinkedList:容量可变,线程不安全,双向链表,所以增删快,随机访问慢
- Set:无序,不可重复,常用:HashSet,LinkedHashSet和TreeSet
- HashSet:无序,唯一,高性能,线程不安全,通过 HashMap 实现,存储的值就是Map的Key,与之对应的V,就是一个名为
PRESENT的 Object 对象 - LinkedHashSet:有序,唯一,性能略低,线程不安全,通过 HashSet + LinkedList 实现,哈希表负责唯一性,双向链表负责有序性
- TreeSet:排序,唯一,不允许NULL,通过 TreeMap 实现底层,保证排序,可以自定义规则
- HashSet:无序,唯一,高性能,线程不安全,通过 HashMap 实现,存储的值就是Map的Key,与之对应的V,就是一个名为
Map:作为双列集合的顶层接口,同样也定义了一些增删改查接口,Map的每一个条目包括K和V,K唯一,V不唯一
- HashMap:经典的Map,JAVA8之前使用数据+链表实现的,对于碰撞的情况使用链表存储,链表过长会影响查询速度,在JAVA8之后采用数组+链表+红黑树,当链表长度达到8之后就用红黑树处理碰撞情况,增加性能
- LinkedHashMap:HashMap + 双向链表,通过重写节点类,在原有的基础上增加before和after,增加了顺序存储的功能
- TreeMap:通过红黑树实现,可以对K进行排序
- ConcurrentHashMap:线程安全的高并发Map,不允许NULL,JAVA7采用分段锁提升性能,每一段数据单独枷锁,JAVA8采用CAS + synchronized,锁的粒度更小,空桶直接插入,有数据的锁住链表或者红黑树的两个头结点,如果两个线程没发生哈希冲突,就能完全并行
List
Java 中的 List 接口有哪些实现类?
List 接口主要有这几个实现类:ArrayList、LinkedList、Vector、Stack、CopyOnWriteArrayList。
常用的就是 ArrayList 和 LinkedList,两者的线程都不安全
ArrayList 底层是数组,LinkedList 底层是链表
线程安全通常选择 CopyOnWriteArrayList,采用写时复制,线程安全
数组和链表在 Java 中的区别是什么?
主要是内存布局,数组是连续的内存,比较紧凑,通过 基地址 + 元素下标 * 元素大小 就能进行快速定位,随机访问速度是 O(1),为了保证连续性,其插入操作需要将后面的元素全部后移,最坏是 O(N),而链表则是通过指针连接起来的,不需要连续空间,在内存中通常是散布的状态,插入操作只需要更改指针就行,O(1),但是访问就得从头开始访问了,效率是 O(N),但是问题有了,如果我们没有拿到要被插入的节点,就要从头开始找了,这效率就很低了。
由于数组的连续性加上现代 CPU 读取缓存的特性,导致数组的缓存友好性更好,这也就是为什么 ArrayList 比 LinkedList 效率更高的原因,虽然理论上他的插入效率更快
数组的代表就是 ArrayList,链表的代表就是 LinkedList,实际情况中除了需要频繁修改头结点和当做队列来用的情况下,都建议使用 ArrayList
LinkedList 为什么实现了 Deque 接口?
LinkedList 天生适用于做队列使用,头尾的增删都是 O(1),所以其能当做数组,队列,栈使用,比较全能了
Java ArrayList 的扩容机制是什么?
ArrayList 在每次添加数据的时候都会对其进行大小检查,如果发现装不下了,就会进行扩容,扩容的基数的1.5,也就是说,10长度的数组被扩容后会变成15,具体来说是:newCapacity = oldCapacity + (oldCapacity >> 1),然后会将数据迁移到新数组,最后修改 elementData 的引用,指向新数组。
如果想要的大小超过了 int 的上限的时候,就通过 hugeCapacity 方法请求提供一个合法的大小,他的逻辑很简单,如果我们请求的大小是一个负数,就意味着之前的加法已经溢出了,这时候就抛出 OutOfMemoryError 表示溢出。接下来,他会返回两种值:
- 一种是
MAX_ARRAY_SIZE,他是Integer.MAX_VALUE -8的值,因为 ArrayList 的头结点根据不同的 JVM 可能存放不同的值,所以空出八个槽位用于数据存储 - 第二种是
Integer.MAX_VALUE他会在请求值大于MAX_ARRAY_SIZE的情况下被返回,跟放手一搏差不多
ArrayList 的 elementData 为什么用 transient 修饰?
为了防止序列化写入过多的空值,elementData 通常情况下实际长度大于使用的长度,默认序列化的时候会将这些空值写入,浪费空间。ArrayList 自己实现了 writeObject 和 readObject 方法,序列化的只有使用的部分,
如果大量创建 new ArrayList 不往里面放东西,有什么危害?怎么解决的?
如果大量创建新的 ArrayList 不仅会占用大量的堆内存,而且对GC的回收负担也很大
解决方法:ArrayList 里提供了两个字段:EMPTY_ELEMENTDATA``DEFAULTCAPACITY_EMPTY_ELEMENTDATA,二者针对长度为0的创建操作和长度为10的默认创建操作进行优化,通过这两种方式创建的数组都指向这两个字段,用于减小内存开销和GC压力
ArrayList 能存多少个元素?
理论上的上限是 Integer.MAX_VALUE也就是大约21亿,但是实际上也受 JVM 限制,如果是64位的JVM,开了压缩指针每个引用也要占用8字节,差不多16G的内存就消耗在了引用上面,另外,数组的头部也有元数据开销,所以也受JVM的内存限制
Arrays.copyOf 和 System.arraycopy 有什么区别?
Arrays.copyOf 底层也是去调用 System.arraycopy 所以其实性能上没差别,但是 System.arraycopy 需要去指定复制到什么地方,Arrays.copyOf 在调用 System.arraycopy 之前就准备好了这个地方,不需要手动指定
Java 中 ArrayList 和 LinkedList 有什么区别?
底层数据结构不同,ArrayList 底层是数组,LinkedList 底层是双向链表,这决定了他们的性能差异
- ArrayList 作为连续的数据结构,查找效率为 O(1),直接定位下标就行,但是插入数据为 O(n),因为需要对后面的元素进行移位
- LinkedList 使用双向链表作为底层结构,查找效率为 O(n),因为需要挨个遍历所有节点,但是对头尾节点的操作是 O(1),改地址就行
实际使用还是推荐使用 ArrayList,连续的数据结构缓存友好
其次,内存占用差距也不小,ArrayList 作为连续的数据结构,每个对象只占一个对象引用,四或八字节(开指针压缩就是四),而双向链表就不同了,他需要存放数据,前驱,后继,对象头,一个节点差不多是二十四字节,开销差了6倍
ArrayList 的中间插入真的很慢吗?
我们了解到的,中间插入要将后面的数据后移,时间复杂度是 O(n),但是,插入操作使用了 System.arraycopy 方法,是 native 方法,适合大批量内存整体移动,CPU对此类操作做了大量优化,其性能开销其实不是很大,远低于链表型数据结构的中间插入操作
为什么 JDK 官方建议用 ArrayDeque 而不是 LinkedList 实现栈和队列?
ArrayDeque 底层是循环数组,内存连续,CPU缓存友好,性能自然高,其次其不像链表,需要维护这么多的指针,开销也小,除非要去存 Null,不然 ArrayDeque 各方面都很优秀
ArrayList 和 Vector 有什么区别?
Vector 老古董了,JDK1的元老,线程安全,所有的方法都加了 synchronized,性能较低。JDK1.2加入了 ArrayList,不加锁,性能好,但是线程不安全,为了线程安全可以使用 synchronizedList 包裹 ArrayList 实现。
Java 中的 CopyOnWriteArrayList 是什么?
CopyOnWriteArrayList 使用写时复制来保证线程安全,具体操作是在写的时候先对旧数组做一份拷贝,然后修改新数组,然后用新数组的引用取代旧数组的引用。读操作直接读取旧数组,实现读写分离
这样就导致写操作的开销比较大,因为每次写都得去复制整个数组,但是读操作非常快,因为没有加锁,适合读多写少的场景
值得一提的是,CopyOnWriteArrayList 的迭代器遍历是弱一致性的,因为迭代器遍历的是迭代器被创建的时候的数组的快照,和写操作隔离
Java 的 CopyOnWriteArrayList 和 Collections.synchronizedList 有什么区别?分别有什么优缺点?
对于保证线程安全的方法不一样,synchronizedList 靠的是给所有方法加锁,这样并发性能低,CopyOnWriteArrayList 采用写时复制设计,读操作不加锁,写操作操作副本,并发程度高,另外 synchronizedList 在迭代器遍历场景下性能不如 CopyOnWriteArrayList 因为 CopyOnWriteArrayList 是使用快照遍历,而 synchronizedList 得加锁
写时复制会不会有内存问题?
会的,如果写入操作十分频繁,就会同时存在多个数组的副本,严重情况可能内存爆掉,抛OOM
CopyOnWriteArrayList 能保证实时一致性吗?
不可以,因为 CopyOnWriteArrayList 采用写时复制技术,读操作本质上只是读取副本,在读操作进行的时候如果有写数据,是拿不到的,如果想要拿到最新数据,就得加锁,这样性能太低,属于是 CopyOnWriteArrayList 高读速的代价了
CopyOnWriteArrayList 在迭代的时候能修改吗?
可以的,迭代操作和修改操作不是操作同一个数组,迭代操作在迭代器创建的时候就拿到了数组的快照,是在这里进行的,修改操作是在新数组上进行的,互相独立,不会抛出 ConcurrentModificationException,但是迭代看到的数据可能是老旧的,当然,这在读多写少的情况下并不可怕
CopyOnWriteArrayList 的迭代器支持 remove 操作吗?
并不支持,因为迭代器操作拿到的是是数据的快照,快照是只读的,强行操作只会抛 UnsupportedOperationException,删除只能调用 CopyOnWriteArrayList 自己的 remove 方法咯
CopyOnWriteArrayList 适合存几万条数据吗?
不适合,CopyOnWriteArrayList 采用写时复制技术,写的时候会 copy 整个数组,如果数据量非常大,每次写的内存开销也非常大,会频繁触发GC,上万的数据还是用别的吧
synchronizedList 和 Vector 有什么区别?
性能上差不多,Vector 的每个方法都加上了 synchronized,synchronizedList 是在最外面套上了 synchronized,Vector 有点老旧,synchronizedList 可以包装任意实现了 List 接口的类,更加灵活
为什么不推荐用 Stack 类?
- stack 继承自 Vector,语义上偏向栈是向量,不准确,而且栈应该只暴露 push / pop / peek 操作,而不应该暴露 Vector 的 get / set / remove 操作
- 由于继承了 Vector,其本身就带有了粗粒度的锁,效率低下
Map
说说 Java 中 HashMap 的原理
- 通过计算 Key 的 HashCode,然后用
(table.length-1) & hash计算出 Value 应该在数组的什么位置,然后存放 - 如果发生哈希碰撞,就把哈希值相同的 Value 通过链表串起来,在 JDK8 之后做了优化,对于长度大于八的链表,且数组长度大于64,使其进化成红黑树,以增加性能,在红黑树节点小于6时,退化成链表
- 如果数组的使用率超过了负载因子,就会进行扩容,数组大小翻倍,然后数据进行迁移,称之为 rehash,性能开销较大
Java 中 HashMap 的扩容机制是怎样的?
- 是否扩容主要有两个东西决定, 容量和负载因子,当使用率超过负载因子的时候,就会触发扩容,容量翻倍并且调整每个元素的位置,容量默认是16,负载因子默认是0.75
- 计算新位置的方法在1.8做了优化,数组的长度永远是二的N次方,根据公式:
(table.length-1) & hash我们发现,在扩容前后,(table.length-1)只有高位多了个1,我们只需要检查hash的这一位是否是1就可以快速判断是否移动就可以 - rehash 的性能开销大,为了平衡查询效率和 rehash 的性能开销,根据泊松分布分析,0.75是最优的解决方案
- 最好的方案就是指定初始的容量,大小为预计数据/0.75,需要注意,这个结果会靠近最近的2的幂次。1000为1024.
假设有一个 1G 大的 HashMap,此时用户请求过来刚好触发它的扩容,会怎样?让你改造下 HashMap 的实现该怎样优化?
- 1G 的 HashMap 显然很大,使用当前线程进行 rehash,就会进行阻塞,肯定不行
- Redis是单线程的,如果他遇到这种大规模 Map 扩容,肯定也有很好的解决方案:渐进式rehash。
- 简而言之就是我们将原来一次性的扩容操作改成分批完成,在这个过程中,我们维护两个数组:
- 原数组,包含未迁移的数据
- 新数组:存储扩容后的数据
- 实现过程就是我们创建好新数组时候,只搬运一点数据,然后记录下当前搬运进度,当有插入,修改,查询的操作时,继续迁移部分数据,直到完成迁移
- 现在有两个数组,
get操作会优先查找新数组,如果没有再去旧数组查找
- 简而言之就是我们将原来一次性的扩容操作改成分批完成,在这个过程中,我们维护两个数组:
- 除了 Redis,ConcurrentHashMap 的多线程渐进扩容也很优秀
- 和 Redis 一样,ConcurrentHashMap 会创建另外一个二倍原数组大小的新数组用于存放迁移后的数据(nextTable),并且不会一次性迁移数据,其他线程可以参与这个迁移过程
- ConcurrentHashMap 维护一个 transferIndex 用于记录当前迁移进度,从高位开始,逐步递减,每个线程都会抢占 transferIndex 的一段范围,执行迁移,如果某个桶的数据迁移完毕,就会将旧表中的引用替换为 ForwardingNode,指向 nextTable。
- 全部迁移完毕之后,nextTable 会替换原数组,nextTable 变为NULL,至此,扩容完成
ConcurrentHashMap 扩容期间,如果一个线程正在查询数据,会被阻塞吗?
很显然不会,ConcurrentHashMap 是异步进行扩容的,也就是说,扩容操作不会阻塞当前使用的线程,当前线程查询数据时,如果当前数据完成迁移,当前哈希桶就会读到 ForwardingNode,指向新表,就从新表读取数据了,不加锁,不阻塞
如果扩容期间,多个线程同时要迁移同一个桶,会冲突吗?
不会,根本不会出现多个线程枪一个桶的情况,因为 ConcurrentHashMap 通过 transferIndex 维护当前迁移进度,每个线程从这里领取桶范围,这个操作是原子性的,一个桶保证只会被一个线程迁移,不会冲突
渐进式 rehash 会不会导致内存占用翻倍?
会的,因为渐进式rehash 需要同时维护两个数组,需要消耗三倍的内存,这其实是一个空间换时间的解决方案,如果内存紧张,这个方案就不是这么适用了,可以考虑分片操作或者直接升级内存容量
如果在扩容期间,频繁进行 put 操作,会不会导致扩容一直完不成?
并不会
- 首先,put 操作会将数据放到新数组中, 不会出现哈希桶已经迁移完的情况下又进来新数据了
- 其次,put 操作会带动旧数据迁移,所以,put 的越快,迁移也越快
- 但是如果咔咔咔一直 put,原数组还没扩容完成,新数组就满了,那就是另外一回事了,我们要重新规划容量了
扩容的时候,链表和红黑树的处理方式一样吗?
不一样
- 链表在被迁移的时候会通过 HashCode的高位情况,分裂成两个链表,高位为1的移动到原下标+旧数组长度的位置,高位为0的保持不变
- 红黑树也是进行这样的操作,分成两个红黑树,但是分完要进行检查,如果节点小于6个,就要进行退化
HashMap 扩容时线程安全吗?
不安全,如果两个线程同时进行扩容操作,就会导致链表成环,get 的时候就会一直循环,爆炸了,1.8改用尾插法解决了这个问题,但是put 的时候还是会丢数据,数据被覆盖,所以,使用 ConcurrentHashMap 更加安全
JDK 8 改成尾插法就完全线程安全了吗?
其实也不安全,尾插法解决的是扩容时形成环的问题,但是并发场景下put还是会丢数据
能不能让 HashMap 不扩容?
当然可以,直接让负载因子非常大,就不会扩容,但是这种方法显然不合适,以为内如果一直不扩容,就会一直发生碰撞,单个桶下的数据急剧增多,查找效率急剧下降,即使有红黑树兜底,频繁树化效率也是惨不忍睹,还是应该预估一下数据的数量,设置好初始容量
Java 中的 hashCode 和 equals 方法之间有什么关系?
equals 相等的对象,hashCode 必须相等;hashCode 相等的对象,equals 不一定相等
这个有什么用呢,如果我们需要更改一个对象的 equals 方法,同时这个对象也要被放到 HashMap 或者 HashSet中,那么也要重写 hashCode 方法,因为 HashMap 和 HashSet 在判断是否相等的时候会优先调用 hashCode 方法,如果没有重写 hashCode 方法,这一关过不去,其也不会去调用 equals 方法,集合的单一性就不能保证了
两个对象 hashCode 相同但 equals 不相等,这种情况叫什么?会影响 HashMap 性能吗?
典型的哈希冲突,如果发生这种情况,HashMap 会将这两个对象以链表的形式组织到一个槽里面,如果之后还发生了碰撞,就加长链表,JDK8 之后,如果链表长度大于8就使用红黑树代替链表,优化查询速度
String 类的 hashCode 是怎么算的?为什么这么设计?
Java 中 String 类的 hashCode 计算方式是一个基于 31 的多项式累加算法,具体来说:h = 31 * h + c,计算完毕之后就进行缓存,因为String不可变,之后直接返回就行。选择 31 作为乘数是因为他是奇质数,计算出来的哈希值比较均匀,而且31正好是32-1,可以被JVM优化为位移和减法,计算效率更高
HashMap 的 key 用可变对象有什么风险?
很简单,如果使用可变对象作为K的话,一旦这个我们更改这个Key,HashCode 也会不一样,我们拿着新的 HashCode 去找,肯定找不到,原来的数据也删不掉,就这样造成了内存泄漏,极其不安全
重写 equals 不重写 hashCode,除了集合出问题,还有什么影响?
基本不会有问题,但是保不齐那天突然要放到里面,还有就是不是我们想放到里面,有些框架需要将具体对象放到集合中进行维护,而那时候又忘了重写,给自己埋雷了属于是
为什么 JDK 1.8 对 HashMap 进行了红黑树的改动?
- 在1.8之前,对于哈希碰撞的处理一般是将这些发生碰撞的对象组织到一条链表进行管理,查询的时候挨个进行比对,效率低下,如果有人故意存入大量互相碰撞的对象,然后查询,就会直接卡死,当当,这就是哈希碰撞攻击
- 1.8采用树化的机制来应对这种问题,简单来说就是当链表的长度大于8且数组长度大于64的时候,就进行树化操作,链表转化为红黑树,查询效率从 O(n) 变为 O(log n)。如果节点数目变为6以下,再次退化成链表
- 使用8和6为界限判断是为了防止这些发生碰撞的数据从链表和红黑树之间反复横跳带来的性能开销
什么是 Hash 碰撞?怎么解决哈希碰撞?
Hash 碰撞就是两个对象经过 Hash 函数计算之后,得到了相同的哈希值,这种情况几乎不可避免,如果我们的哈希数组有16大小,而我们有17个数据,那就一定会发生碰撞
主要解决办法:
拉链法:将发生碰撞的两个对象通过链表组织起来,查询的时候遍历整个链表,相同就输出,插入的时候插到尾部,优点就是方案简单,内存利用率高,缺点就是链表查询速度慢,容易被攻击,可以通过树化链表解决
开放寻址法:我们不使用额外的结构来组织发生碰撞的对象,而是让碰撞的对象在数组中以一定的方式自己寻找空位,常用探测方式:
- 线性探测:如果当前位置不是空位,就往下+1的位置找,如果还不是就接着找
- 二次探测:如果当前位置不是空位,就往当前位置 + 1^2找,如果没有就是 + 2^2找
很显然,查找的时候就也得按照这种方式查找,删除操作就显得麻烦,因为如果单纯的删除元素,会导致后面的元素被丢失,所以要打标记,逻辑上来说比较麻烦,而且容易堆积,性能低下
再哈希法:如果计算发生冲突,那我们换一个哈希值再算一次就好了,一直到找到空位 很明显,这种方式计算方面开销比较大,而且我们需要准备好几个优质的哈希函数,比较麻烦
为什么 HashMap 选择拉链法而不是开放寻址法?
主要是为删除效率考虑,HashMap 需要支持频繁的增删改查,如果使用开放寻址法来说,删除的开销会大得多
其次就是 HashMap 的负载因子是 0.75,这个负载因子如果使用开放寻址法,性能就会变的低下
Java 中的 WeakHashMap 是什么 ?
WeakHashMap 是特殊的 Map 实现,他的键使用弱引用包装,这意味着如果外部没有强引用,他就会被清理掉,随后,WeakHashMap 会清理掉这个键值对。我们可以通过这个特性将一些对内存敏感的缓存放到这里,这样当程序不再使用这个值的时候,他会被清理,防止内存泄露
WeakHashMap 的 value 是强引用还是弱引用?会不会内存泄漏?
Value 是强引用,但是 WeakHashMap 在每次被操作的时候,都会触发 expungeStaleEntries()方法,清理掉失效的entity,也就是 key被回收的导致的失效,但是如果只是往 WeakHashMap 存入东西后就不操作了,Key 被 GC 回收后,Value 确实会发生泄露
WeakHashMap 是线程安全的吗?多线程环境下怎么用?
不安全,多线程可以用 Collections.synchronizedMap 包一层,也可以换成 Guava 的 Cache 进行缓存的实现,本身也支持并发,ConcurrentHashMap 包不了弱引用,不能作为 WeakHashMap 的替代品
WeakHashMap 的 value 会被自动回收吗?
不会,WeekHashMap 的 Value 是强引用的,Key 才是弱引用,当 Key 被回收之后,Value 成了孤儿,然后当 WeakHashMap 被操作的时候,会触发 expungeStaleEntries()方法,这个时候,成为孤儿的 Value 才会被回收,如果想要 Value 也被主动回收,可以用 WeakReference 包装 Value。
Hash 洪水攻击是怎么回事?怎么防范?
攻击者通过向哈希表中存入大量哈希值相同的不同对象,导致其都挂载到一个桶上,如果使用拉链法,查询效率就会从 O1 退化到 On,JDK8 优化了这一问题,链表在长度达到8的时候会向红黑树转化,使得查询效率优化到 O(log n),
负载因子和碰撞概率有什么关系?
负载因子等于 元素个数/数组长度,也就是说,当负载因子越小,数组里面的东西越少,发生碰撞的概率越小,相应的,要更加频繁的扩容,空间利用率低,但是查询速度快,如果负载因子大,扩容速度慢,空间利用率高,但是查询速度会放慢
实际项目中你会去改这个负载因子吗?什么情况下会改?
并不会改,这玩意是经过数学验证的,是一个很好的平衡点,适用于大部分场景,当然,如果内存很紧张,比如嵌入式设备,会调整比较高,如果对查询速度有要求,可以调的比较低
ConcurrentHashMap 的负载因子也是 0.75 吗?能改吗?
是的,而且不能改,这玩意是写死的,官方并没有为了这个去增加一个API,当然可以通过反射来更改,但是也不推荐
简单解释下为什么用泊松分布来分析树化阈值吗?
当负载因子为0.75 的时候,λ 大约是 0.5,同时有八个元素在一起的概率变的相当低,所以这是有数学依据的
Java 中的 TreeMap 是什么?
TreeMap的底层是红黑树,先天具有排序功能,也可以自定义排序规则
Java 中的红黑树是什么?
红黑树就是一个二叉树,所以查找也是二叉搜索数查找,比当前节点小就往左走,大就往右走
TreeMap 和 TreeSet 是什么关系?
其实 TreeSet 就是对 TreeMap 的复用,其中 Key 就是实际的值,Value 就是一 Object 站位,
为什么红黑树比 AVL 树更常用?
红黑树的平衡条件是左右子树的高度差不超过两倍,AVL树的平衡条件是高度差不超过1,显然AVL树的平衡条件更加严格,导致下面两种情况:
- 红黑树由于平衡条件宽松,旋转次数少,树高高,导致插入,删除效率高,查找效率低
- AVL树由于平衡条件严格,旋转次数多,树高低,导致查询效率高,插入,删除效率低
对于工程上写多读少的情况,属于红黑树的优势区间,AVL树来说,更加适用于数据库的情景
TreeMap 能保证线程安全吗?怎么在多线程环境下使用?
不能保证线程安全,可以使用 Collections.synchronizedSortedMap 包一层,或者使用 ConcurrentSkipListMap,ConcurrentSkipListMap底层是跳表,比加锁的红黑树性能优越
红黑树的旋转操作是什么意思?为什么需要旋转?
红黑树的旋转操作是在平衡被打破的时候需要进行的调整操作,分为左旋和右旋,左旋就是让自己的右节点作为自己的父节点,自己成为右节点的左节点,这样不影响二叉搜索树的性质,只改变高度,目的是维持平衡性
ConcurrentHashMap 也有红黑树吗?实现上有什么不同?
是的是的,但是区别就是 ConcurrentHashMap 在树化发生的时候给头结点加锁,保证线程安全,
另外 HashMap 中哈希桶的头结点就是红黑树的根节点,但是在并发场景下操作时非常危险的,因为红黑树会旋转,所以加锁并不靠谱,头结点可能会旋转,导致锁失效,ConcurrentHashMap 维护了一个 TreeBin 节点,其实就是对红黑树的根节点做了封装,加锁就是加的这个节点的锁,更加安全
HashMap 的 key 可以用 null 吗?
可以的,null 的 HashCode 是0,直接放在第一个桶里面,但是并发场景下,使用 ConcurrentHashMap 的话就不支持了,因为 null 无法保证是值,而不是空
使用 HashMap 时,有哪些提升性能的技巧?
首先影响 HashMap 的主要因素就是发生哈希碰撞引起的查找效率下降和发生扩容时的 rehash 操作。着手优化这两点就行
- 负载因子不乱调,0.75 是官方精心测试的值,在这个值下,发生碰撞的概率比较小,而且空间利用率高
- Key 的 HashCode 方法必须使其均匀分布,防止堆积导致查询效率降低
- 预估初始容量,防止频繁扩容,rehash 的开销不小,频繁的进行扩容操作会吃掉大部分资源,所以根据这个map要存放多少值设置初始容量也很有效
其次,在遍历场景的时候,使用 KeySet 拿到所有的 key,然后再靠 key 拿到所有的 value 是非常傻的,可以直接使用 entrySet 来获取 HashMap 中的 Entity 对象,这样可以避免一次的 Hash 开销
HashMap 给太大会有什么问题?
第一就是会造成内存的浪费,给一万实际存10,内存直接就浪费了,其次就是缓存不友好,命中率低。实际中还是估算应该用多少然后给多少。
ConcurrentHashMap 和 Collections.synchronizedMap 有什么区别?
synchronizedMap 的实现原理是给所有的操作都加了锁,任何操作都是互斥的,安全得很,同时性能也低得很,ConcurrentHashMap 在 JDK7 之前的解决方案就是给数据进行分段加锁,细化锁的粒度,性能提升明显,JDK8 又做了优化,使用 CAS + synchronized 锁住单个桶,粒度更小,并发场景下效率比 synchronizedMap 高好几倍
为什么 HashMap 的容量必须是 2 的幂次?
因为 HashCode 的计算方式是 (size - 1)& hash如果使用二的幂次方,size - 1 全是连续的1,等价于取模,而且容量是二的幂次方,扩容可以迅速判断是否移动,不用重新计算哈希值
HashMap 在被创建的时候,容量总是2的幂次方,也就是说传入1000会变成1024
位运算比取模快多少?有没有具体的性能数据?
x86 的系统架构下,除法需要 20 到 40 个时钟周期,而位运算只需要一个就可以了,差的不是一点半点,其实从操作上来说感知其实差距不大,但是 HashMap 的存取操作十分频繁,差距就体现出来了,对于一些高性能框架,使用位运算优化是很常见的操作
ConcurrentHashMap 和 Hashtable 的区别是什么?
Hashtable 和 ConcurrentHashMap 都是线程安全的 map,但是实现方式不同
- Hashtable 非常暴力,在整个 map 上加了一个大锁,所以并发性能很差
- ConcurrentHashMap 将整个哈希桶分成了 16 个部分,每个单独加锁,理论上可以有16 个线程去同时访问,在JDK8之后,又做了优化,现在锁的粒度是每个桶,并发效率更高
另外 Hashtable 和 ConcurrentHashMap 都不能存储 null,都是因为不能保证多线程情况下放的到底是 null 还是确实不存在
说说ConcurrentHashMap 的 CAS + synchronized 机制?
CAS + synchronized 机制是针对不同情况下的哈希桶的操作。
- CAS 是针对空的哈希桶的操作,使用 CAS 直接插入新节点,不用加锁
- synchronized 是针对发生了哈希碰撞的桶采取的情况,他会将哈希桶的头节点加锁,也就是 Node 或者 TreeBin,来保证线程安全
说说 ConcurrentHashMap 对 size 方法的特殊处理?
对于并发场景下使用的 ConcurrentHashMap 来说,维护一个全局的,单一的 size 是不现实的,不可能所有 put 的线程都去做 size 的竞争
ConcurrentHashMap 创建了两个地方用于存储:
- baseCount:作为基础计数,在竞争不激烈的情况下,BaseCount 会去更新,
- counterCells 是一个数组,当 baseCount 被使用的时候,其他线程就去这个数组,随机的找一块地方更新一下就完了
然后计数的时候就将他们加起来,这就是最后得到的 size
这样做肯定不精确,因为可能会发生前面的数组刚被遍历完,又被更改了的情况,导致得到的结果是近似值,但是问题不大啦,对于 ConcurrentHashMap 来说,最终一致性已经很不错了
Java 中 ConcurrentHashMap 1.7 和 1.8 之间有哪些区别?
- 锁的粒度:1.7使用的是多个 Segment 数组,他们共同组成 ConcurrentHashMap,每个 Segment 数组单独加锁,以此提高并发效率。1.8 使用整个数组来作为 ConcurrentHashMap,每个哈希桶使用 CAS + synchronized 提升并发效率
- 扩容:1.7 之前因为使用的是分段管理,所以每个 segment 数组单独维护自己的扩容,每个 segment 都有自己的负载因子,扩容的时候单个扩容,不影响其他的 segment 工作。1.8 使用整体数组,当需要扩容的时候,整体开始扩容,过程通过 CAS 确保线程安全,而且引用渐进式扩容,提升了扩容效率,而且来访问的其他线程发现正在扩容之后,也会去协助扩容
- size 的计算区别:1.7 使用分段数组,计算总体 size 的时候,有一个小巧思:他会先进行不加锁的计算所有 segment 的 size 的 sum。如果三次都一样,说明结果是对的,数量没有变化,就直接返回,如果数量有变化,就说明当前有线程去操作数组,就会将整体的数组进行加锁,然后去计算。1.8 之后采用的设计是维护了两个变量,一个是 long 类型的 BaseCount,另外一个就是 CounterCell 数组,CounterCell 里面只有一个 long 类型的 Value。使用 Contended 来防止伪共享。当发生增删的时候,首先去操作 BaseCount,如果 BaseCount 正在被使用,转而去 CounterCell 数组中随便找个地方记录一下更改,之所以重新创建一个 CounterCell 对象,是为了防止连续的数组带来的伪共享。计算 size 的时候,就把他们的加起来就行了
ConcurrentHashMap 的 1.8 的渐进式扩容会不会导致读操作读到不一致的数据?
并不会,原理是正处于扩容时的 ConcurrentHashMap 在被读取数据的时候会去旧数组中读取数据,如果当前哈希桶被迁移完毕,他会将这个哈希桶置为:ForwardingNode,这个节点的哈希值为 -1,当读取到这个值的时候,会去新数组中读取数据,所以能正确读到
ConcurrentHashMap 的 key 和 value 能不能为 null?为什么?
不可以,因为在并发场景下,不能准确区分是完全没有这个值还是用 Null 表示值,containsKey 也不能区分,因为在调用 containsKey 和 git 之间可能有别的线程来修改值,导致结果并不准确
如果业务上必须用 ConcuttentHashMap 存储 Null 怎么办?
可以使用一个特殊的占位符代表,取的时候检测一下,如果是的话就返回 Null 就可以了
HashMap 为什么可以存 null?
因为 HashMap 用于单线程下,在单线程下,containsKey 和 get 之间不会有别的线程来捣乱,所以并不会出现 null 歧义的问题
Hashtable 也不支持 null,是因为并发问题吗?
HashTable 老古董了,当时就不允许使用 Null,也没有说明原因。后面的 ConcuttentHashMap 沿用了这个设计,并且说明了原因,可以让语义更加清晰
Java 中的 HashMap 和 Hashtable 有什么区别?
- 线程安全:HashMap 线程不安全,但是单线程下性能高,HashTable 线程安全,但是效率低下
- NUll 处理:HashMap 允许一个 NUll K 和 多个 NUll V,但是 HashTable 不允许 NUll
- 继承不同,HashMap 继承自 AbstractMap,HashTable 继承自 Dictionary ,这玩意早就废弃了
- 迭代器机制差异,HashMap 使用的是 fail-fast 迭代器,在结构改变的时候会直接报错,而 HashTable 是弱一致性,改变了也不会报错
Java 中 ConcurrentHashMap 的 get 方法是否需要加锁?
不需要的,首先要清楚 get 操作需要几步完成:
- 通过 Hash 计算下标,然后通过 getObjectVolatile 读取数组槽位
- 解决哈希冲突,通常是遍历链表 / 红黑树
- 读取最后的值
这三部分的指令都是用 volatile 保证可见性的,并不用加锁
既然 ConcurrentHashMap 的 get 不加锁,那 put 的时候 get 会不会读到中间状态?
并不会,PUT 操作会先构建好 Node 节点,最后通过 CAS 直接添加进去,所以 get 方法要么读取到旧值,要么是新值
ConcurrentHashMap 的 size 方法是准确的吗?
不准确,尤其是在高并发场景下,为了性能,concurrentHashMap 并没有对 size 进行加锁操作,所以取到的是近似值,可以自己维护一个 AtomicLong 用于计数
为什么数组元素不直接用 volatile 修饰,而要用 Unsafe 来读?
不可以,volatile 只能修饰变量,不能针对数组中的某个值进行修饰,volatile Node[] table 也只是保证对数组引用的可见性,所以 Java 采用 Unsafe 类来实现安全读
既然 ConcurrentHashMap 这么好用,为什么不干脆把 HashMap 也做成线程安全的?
因为 HashMap 本身就是为了单线程的环境设计的,加锁反而降低性能,就算是 CAS 也要有开销
ConcurrentHashMap 能保证复合操作的原子性吗?比如先判断再插入?
不可以,单个的 get 和 put 都是原子的,但是 if-absent-then-put 这种操作是不行的,ConcurrentHashMap 提供了 putIfAbsent、computeIfAbsent 这些原子方法来解决这个问题
高并发场景下,ConcurrentHashMap 和加了 synchronized 的 HashMap 哪个快?
ConcurrentHashMap 快,Synchronized 是在外面套了个锁,所有的操作都互斥,和 HashTable 没区别了, ConcurrentHashMap 的锁粒度在 1.8 之后优化到了桶级别,而且读操作不加锁,效率大大滴
Java 中的 LinkedHashMap 是什么?
LinkedHashMap 继承 HashMap,然后在每个节点上面维护了两个节点用于组成双向链表
它有两种排序模式,第一种是插入顺序,谁先 PUT 谁就在前面,第二种是访问顺序,谁被 get 、put 谁就被移动到最后面
这种结构非常适合做 LRU 缓存
LinkedHashMap 是线程安全的吗?多线程环境下怎么用?
不安全,因为继承自 HashMap,本身又没做处理,所以线程不安全,如果想要线程安全的话,可以使用 Collections.synchronizedMap 包装一下,或者使用 ConcurrentLinkedHashMap 的第三方库
LinkedHashMap 遍历的时间复杂度是多少?和 HashMap 有什么区别?
O(N),但是这个遍历的时候不会走空桶,因为他是使用链表管理的
accessOrder 为 true 时,哪些操作会触发节点移动?
accessOrder 为 true 代表要按照访问顺序排序,get、getOrDefault、compute、computeIfPresent、merge 这些读写操作,还有 put 已存在的 key,都会触发 afterNodeAccess 把节点挪到尾部。单纯的 containsKey 不会触发,因为它只是查有没有,不算"访问"
为什么 LRU 要用双向链表?单向链表行不行?
不行,删除节点需要同时更新前后两个节点,为了效率不能再从头遍历,效率太低
Java 中的 IdentityHashMap 是什么?
identityHashMap 是一种特殊实现,他判断两个键是否相等用的是 ==,而不是 equals,也就是说,他只认这个对象本身作为键,举例来说,我们可以往里面放两个 new String(1),他算作两个对象,因为两个字符串的内存地址不相同
底层实现直接用的是 Obj 的数组,偶数下标是 k,奇数下标是 v,内存紧凑,缓存命中率高,但是使用探针寻址,处理冲突效率低
什么情况下用 IdentityHashMap 会踩坑?
拿字符串做 K 的时候会容易出现问题,"abc" 和 new String("abc")不是一个东西,会变成两个 key
System.identityHashCode 和对象默认的 hashCode 有什么关系?
如果没有重写 hashCode 方法, 返回值是一样的,如果重写了,调用前者仍然返回之前的地址相关值,就是为了有一个保底的手段用来计算相关值,防止重写丢失功能
Set
Java 中的 HashSet 和 HashMap 有什么区别?
存储模型不同,HashSet 存储单列数据,HashMap 存储双列数据
但是 HashSet 底层套了 HashMap,他的 K 就是 Set 的值,Value 统一设定为 PRESENT 的空 Object 占位,所以 HashSet 的去重,查找的本质就是 HashMap 对 K 的操作
HashSet 套用 HashMap Value 的位置不就浪费内存空间了吗?
不是,Value 统一设定为 PRESENT 的空 Object 占位,这个东西是单例的,也就是说,所有的 Value 都指向一个东西,并不会浪费内存
LinkedHashSet 和 TreeSet?
LinkedHashSet 底层是 LinkedHashMap,通过双向链表维护插入的顺序
TreeSet 底层是 TreeMep,底层是红黑树,支持自定义排序,查找速度慢,但是支持一些范围查询操作
HashSet 的 add 方法返回值是什么含义?
本质上是套用 HashMap 的 put 方法,表示集合是否发生了变化,也就是说,如果之前没有这个值,插入了,就返回 true,如果之前就有这个,插入了,就返回 false。
HashSet 怎么判断两个元素是否相等的?
首先计算 HashCode,如果不相等直接过,相等就用 equals 判断,不相等就直接过,所以自定义对象的存储,必须同时重写 HashCode 和 equals
如果只重写 equals 不重写 hashCode 会怎样?
如果不重写 HashCode,不同对象的 内存地址肯定不同,算出的 HashCode 极大概率不同,HashSet 就失去了去重的能力,就废了
其他
你遇到过 ConcurrentModificationException 错误吗?它是如何产生的?
它是由于迭代器 fail-fast 机制抛出的异常,用于检测一边遍历一边修改的操作
具体来说就是:集合维护了一个 modCount 变量,用于计算集合被修改的次数,当迭代器被创建的时候,他会拷贝一份备份出来,每次遍历的时候会进行一次对比,当两个值不相等的时候说明发生了修改,修改了就报错
用 synchronizedList 包装 ArrayList 能避免这个异常吗?
不会,synchronizedList 只是给每个方法加锁,方法之间还是可以并行访问的,要么直接换 CopyOnWriteArrayList,他直接在迭代器创建的时候弄个快照
ConcurrentHashMap 迭代器迭代时能保证看到最新数据吗?
不能,其迭代器是弱一致性的,创建之后的迭代器是看不到遍历过后的桶的新数据的
为什么 CopyOnWriteArrayList 写入性能差?
因为使用写时复制技术,每次写入都要 copy 一整个新数组,如果数据量很大,copy 的开销也会直线上升,GC的压力也大,这玩意适合读多写少的场景